

Votre PC manque de VRAM pour faire tourner ComfyUI, Flux ou un gros LLM ? Runpod permet de louer un GPU puissant à la demande, sans acheter une carte graphique hors de prix. Voici comment choisir la bonne configuration, protéger ses fichiers et couper la facture au bon moment.
En 2023, le secteur technologique qualifiait de « GPU poor » les créateurs dépourvus de puces graphiques performantes. Face à l’envolée des prix du matériel, Runpod démocratise la location horaire de GPU cloud. Cette plateforme héberge des modèles exigeants en VRAM comme ComfyUI, Flux ou des LLM. Une gestion précise du stockage et des arrêts de machines maîtrise la facture finale.
L’essentiel à retenir,
- Runpod permet de louer des GPU performants dès 0,27 $/h pour exécuter ComfyUI, Flux ou des LLM.
- L’option Stop interrompt les frais de calcul, mais seul Terminate efface le Volume Disk facturé.
- Cette solution réduit les coûts d’intelligence artificielle jusqu’à 66 % face aux hyperscalers comme AWS.
Votre PC cale ? La VRAM est dans plusieurs cas le vrai mur
Tout se passe bien jusqu’au moment où le modèle devient trop gros. Stable Diffusion accepte encore de travailler, puis ComfyUI réclame davantage de mémoire, le LLM refuse de se charger et le fine-tuning transforme l’ordinateur en chauffage d’appoint. Acheter une nouvelle carte graphique peut résoudre le problème, à condition d’avoir plusieurs centaines ou plusieurs milliers d’euros à immobiliser pour un usage parfois occasionnel. L’IA générative appliquée aux contenus immersifs ne fait qu’accélérer cette course à la puissance.
Runpod propose une autre logique : louer une machine équipée d’un GPU pendant quelques minutes ou quelques heures, l’utiliser depuis un navigateur, puis la couper. Une RTX 4090, une A100 ou une H100 devient accessible sans être installée sous votre bureau. C’est l’équivalent d’un garage rempli de bolides, sauf que le compteur tourne dès que vous mettez le contact.
Le bouton Deploy donne pourtant une impression trompeuse de simplicité. Derrière lui se cachent plusieurs types d’offres, trois formes de stockage, des tarifs qui varient selon le GPU et une différence cruciale entre Stop et Terminate. Ce guide reprend donc le parcours depuis le début : choisir la bonne formule, lancer un Pod ComfyUI, générer une première image et repartir sans laisser une facture ronronner toute la nuit.
Runpod, c’est quoi exactement ?
Runpod est une plateforme de calcul cloud spécialisée dans les charges de travail liées à l’intelligence artificielle, au machine learning et au calcul intensif. Au lieu de proposer des centaines de services généralistes comme AWS, Google Cloud ou Azure, elle met surtout en avant des instances GPU, des modèles prêts à appeler et des environnements préconfigurés. La première difficulté consiste à ne pas mélanger toutes les briques du catalogue. Un Endpoint n’est pas une offre concurrente de Serverless, et Secure Cloud n’est pas un produit placé à côté des Pods. Voici la carte correcte.
| Solution | Ce qu’elle fournit | Usage logique |
|---|---|---|
| Pods | Une instance GPU ou CPU dédiée dans laquelle vous contrôlez le conteneur, les fichiers et les outils. | Découverte, développement, ComfyUI, notebooks, entraînement et longues sessions. |
| Serverless | Des workers qui traitent les requêtes reçues par un Endpoint et peuvent monter ou descendre en charge. | API, application web, production et trafic irrégulier. |
| Public Endpoints | Des modèles déjà déployés, appelables directement par API sans gérer de machine. | Tester rapidement un modèle ou intégrer une fonction prête à l’emploi. |
| Instant Clusters | Plusieurs noeuds GPU reliés pour le calcul distribué. | Entraînement à grande échelle et calcul haute performance, pas un premier essai. |
La meilleure formule de cloud à choisir pour démarrer sur Runpod
La documentation officielle présente aussi Flash comme un moyen d’exécuter des fonctions Python sur des GPU distants depuis un environnement local. Pour un premier contact, cela peut attendre. Dans la famille des Pods, Secure Cloud et Community Cloud désignent deux origines d’infrastructure.
Secure Cloud tient sur des centres de données mieux standardisés et vise les charges sensibles ou la production. Community Cloud s’appuie sur des fournisseurs distribués, avec une disponibilité et une fiabilité plus variables. Le choix se fait donc à l’intérieur du déploiement d’un Pod.
Le choix le plus simple pour débuter : Prenez un Pod On-Demand avec un template officiel. Vous gardez une interface visible, un accès aux fichiers et la possibilité de comprendre ce qui se passe. Serverless devient intéressant une fois le workflow stabilisé et prêt à être appelé par une application.
Combien coûte réellement Runpod ?
Runpod fonctionne avec des crédits prépayés. Vous ajoutez de l’argent au compte, puis les ressources consomment ce solde. Les crédits sont non remboursables et un nouveau Pod exige au moins l’équivalent d’une heure de fonctionnement. Pour un premier essai, il n’est donc pas nécessaire de charger 100 dollars : la documentation indique qu’il est possible de commencer avec 10 dollars.
Les tarifs ci-dessous correspondent à la grille officielle de Runpod, mise à jour le 17 juillet 2026 et consultée le 28 juillet 2026. Ils se maintiennent comme des repères, pas une promesse éternelle : la disponibilité varie selon le centre de données et le type de cloud.
| GPU | VRAM | Prix affiché | Profil conseillé |
|---|---|---|---|
| RTX A5000 | 24 Go | 0,27 $/h | Tests économiques, petits modèles et développement |
| L4 | 24 Go | 0,39 $/h | Inférence efficace et workloads modérés |
| A40 | 48 Go | 0,44 $/h | Davantage de VRAM sans passer sur une carte très coûteuse |
| RTX 4090 | 24 Go | 0,69 $/h | ComfyUI, génération d’images et calcul rapide |
| RTX 5090 | 32 Go | 0,99 $/h | Modèles compatibles Blackwell et marge mémoire supplémentaire |
| L40S | 48 Go | 0,99 $/h | Inférence lourde, vidéo et modèles plus volumineux |
| A100 PCIe | 80 Go | 1,39 $/h | Gros modèles et fine-tuning |
| H100 PCIe | 80 Go | 2,89 $/h | Production et entraînement exigeant |
Comprendre la mécanique de facturation et éviter les mauvaises surprises
Les Pods affichent un prix horaire, mais le calcul, le Container Disk et le Volume Disk sont décomptés à la seconde. Le Network Volume fait exception : sa facturation est horaire. Deux heures sur une RTX 4090 représentent donc environ 1,38 dollar de calcul. Dix heures par semaine reviennent à environ 27,60 dollars sur quatre semaines. En revanche, la même carte laissée active 24 heures sur 24 pendant 30 jours approche 496,80 dollars, avant même d’ajouter le stockage.
Serverless n’est pas automatiquement moins cher. Son intérêt vient surtout de la mise à l’échelle : un worker flexible peut redescendre à zéro quand aucune requête n’arrive. Le tarif actif peut être supérieur à celui d’un Pod, et le premier appel après une période d’inactivité peut subir un cold start pendant le démarrage du conteneur et le chargement du modèle.
Attention au faux plafond. Le Spending Limit de 80 dollars par heure mentionné par Runpod est une limite de compte par défaut, pas un budget mensuel personnalisable. Pour contrôler la dépense, activez l’alerte de solde faible et surveillez Billing. L’auto-pay évite les interruptions, mais il évite aussi que votre solde vide serve de frein d’urgence.
Choisir le GPU selon la VRAM, pas selon le prestige
Le meilleur GPU n’est pas forcément le plus puissant de la liste. La première question concerne la quantité de mémoire vidéo nécessaire. Si le modèle n’entre pas dans la VRAM, une carte très rapide ne peut pas négocier avec la physique. À l’inverse, louer 80 Go pour générer quelques images avec SDXL revient à réserver un semi-remorque pour transporter un sac de courses.
- 8 à 16 Go : petits modèles de vision, essais légers et génération d’images avec résolution ou batch réduits.
- 24 Go : zone confortable pour SDXL, de nombreux workflows Flux, l’inférence de LLM quantifiés de 7 à 13 milliards de paramètres et une grande partie des usages créatifs.
- 32 à 48 Go : modèles plus volumineux, vidéo, batchs plus grands, LLM quantifiés plus ambitieux et davantage de marge pour le fine-tuning.
- 80 Go et plus : gros LLM, entraînement, fine-tuning lourd ou contraintes de production qui justifient réellement la dépense.
Sélectionner le bon GPU selon la mémoire VRAM requise
La documentation de Runpod estime qu’un LLM de 7 à 13 milliards de paramètres peut généralement viser 24 Go, tandis qu’un modèle de 30 à 70 milliards demande plutôt 48 à 80 Go. La quantification change fortement l’équation : un modèle 70B en 4 bits peut descendre autour de 35 Go, avec des compromis de qualité, de vitesse et de contexte selon l’outil.
Pour ComfyUI, une RTX 4090 constitue un choix simple lorsque la vitesse compte. Une A40 ou une RTX A6000 peut offrir 48 Go à un tarif parfois très compétitif si le workflow réclame surtout de la mémoire. Les A100 et H100 deviennent pertinentes lorsque la bande passante mémoire, la précision ou l’entraînement l’exigent. Elles ne sont pas des badges VIP à sélectionner par réflexe. Le même appétit de calcul apparaît derrière l’architecture GPU de Midjourney V8.
Méthode saine. Commencez par le GPU le moins cher qui possède assez de VRAM. Lancez un test court, observez la mémoire avec nvidia-smi, puis montez en gamme uniquement si le modèle ne charge pas ou si le temps d’exécution devient réellement pénalisant.
Le stockage : le piège que le bouton Stop ne désamorce pas
Runpod propose trois formes de stockage. Les confondre peut soit supprimer un modèle de plusieurs gigaoctets, soit laisser une ressource payante tourner après l’arrêt du GPU.
| Stockage | Après Stop | Après Terminate | Tarif de référence |
|---|---|---|---|
| Container Disk | Non, les données sont effacées | Non | 0,10 $/Go/mois lorsque le Pod tourne |
| Volume Disk | Oui | Non, supprimé avec le Pod | 0,10 $ actif ; 0,20 $ arrêté |
| Network Volume | Oui | Oui, indépendant du Pod | 0,07 $/Go/mois sous 1 To |
Le Container Disk accueille l’environnement temporaire. Son contenu disparaît à l’arrêt. Le Volume Disk conserve le dossier de travail lors d’un Stop ou d’un redémarrage, mais il est supprimé lorsque le Pod est terminé. Le Network Volume existe indépendamment du Pod : il peut survivre à sa suppression et être rattaché à d’autres déploiements compatibles.
Maîtriser le stockage réseau et sécuriser la sauvegarde des données
Un Network Volume doit être choisi lors de la création du Pod et ne peut pas être détaché ensuite. Pour les Pods, il n’est disponible qu’en Secure Cloud : Community Cloud sort donc de l’équation. Le volume est aussi lié à un centre de données, ce qui peut réduire le choix de GPU disponibles dans cette zone. Sa taille peut être augmentée, jamais réduite : il est plus intelligent de prévoir que de louer 500 Go pour y ranger trois workflows.
Ce n’est pas une sauvegarde. Runpod précise que son stockage n’est pas conçu pour l’archivage à long terme. Si le solde est à zéro et que les frais ne peuvent plus être prélevés, un volume peut finir par être supprimé. Les modèles rares, datasets, LoRA, workflows et résultats irremplaçables doivent également exister sur votre ordinateur ou chez un fournisseur de stockage externe.
- Test unique de 30 minutes : gardez la configuration du template et téléchargez immédiatement le résultat.
- Usage régulier : si Secure Cloud vous convient, créez un Network Volume de taille raisonnable pour les modèles, workflows et sorties.
- Projet important : ajoutez une sauvegarde locale, S3, Google Cloud Storage, Dropbox ou un autre service séparé.
Créer son compte et préparer le premier déploiement
L’inscription s’effectue depuis Runpod.io. Ajoutez un moyen de paiement, créditez le compte avec une petite somme et ouvrez immédiatement Billing pour activer une alerte de solde faible. Les cartes passent par Stripe ; les paiements en cryptomonnaies et la facturation professionnelle existent également selon les conditions précisées par Runpod.
Créer un compte Runpod avec le lien partenaire de Realite-Virtuelle.com
Transparence : Realite-Virtuelle.com peut recevoir une commission si vous vous inscrivez par ce lien, sans surcoût pour vous.
- Déposez seulement la somme nécessaire au test initial.
- Laissez l’auto-pay désactivé si votre priorité absolue est de plafonner le risque.
- Ajoutez une clé SSH au compte si vous prévoyez d’utiliser VS Code, SCP ou un terminal distant.
- N’insérez jamais une clé API directement dans un template public ; utilisez les secrets Runpod.
Tutoriel : déployer un Pod ComfyUI
ComfyUI constitue un bon premier test : l’interface est graphique, le résultat est immédiat et le besoin en GPU saute aux yeux. Runpod maintient désormais un template officiel qui installe également ComfyUI Manager.
- Ouvrez la section Pods de la console et cliquez sur Deploy.
- Sélectionnez le template officiel ComfyUI. Pour une RTX 5090 ou une B200, choisissez ComfyUI Blackwell Edition ; les autres GPU utilisent le template standard.
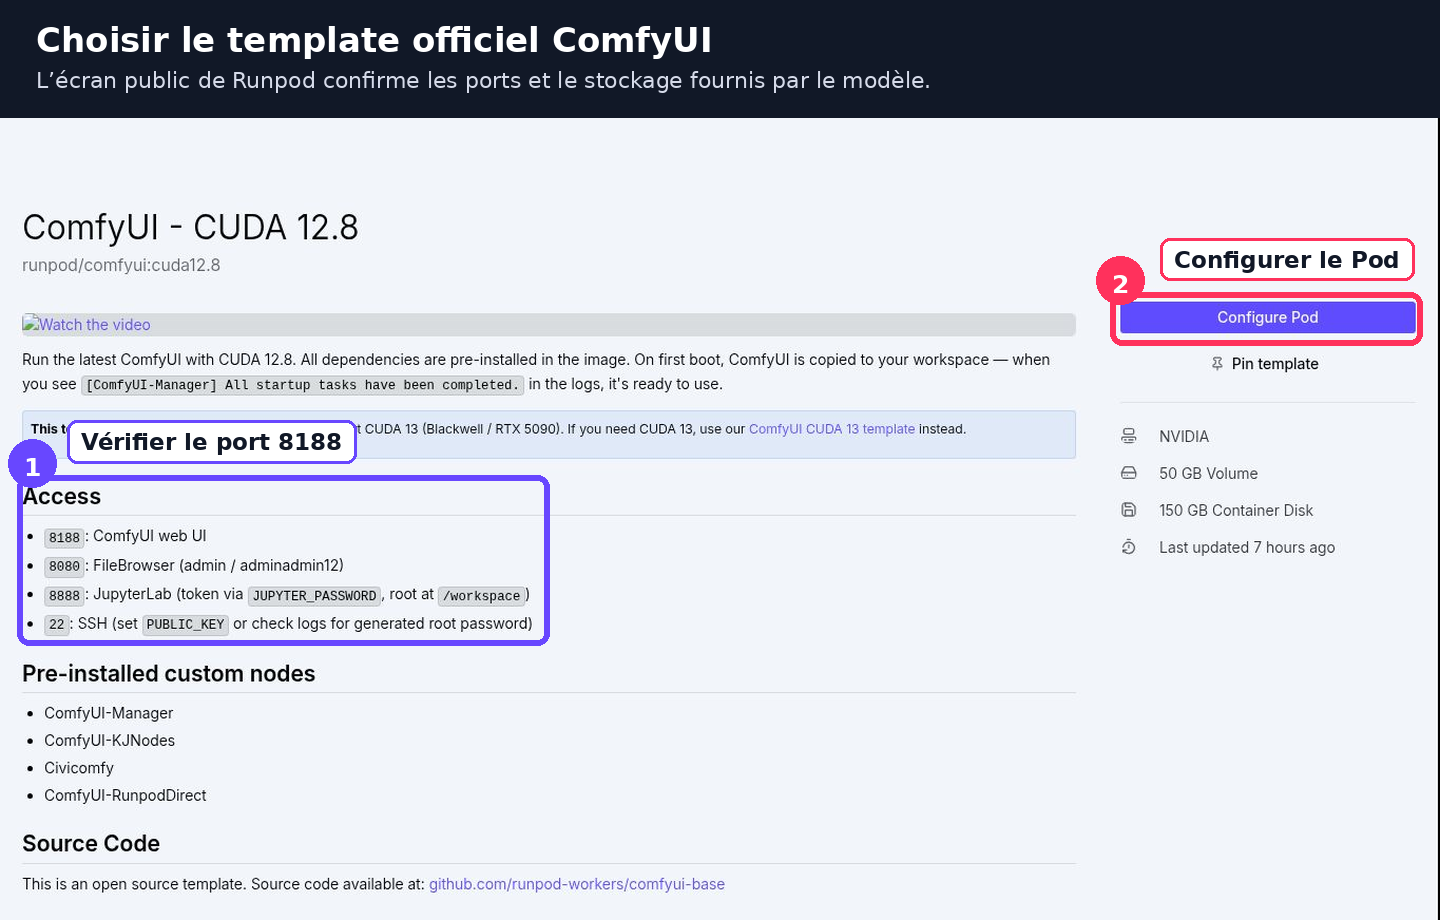
- Choisissez On-Demand. Cette formule n’impose pas d’engagement et ne peut pas être interrompue par un autre client comme une instance interruptible.
- Sélectionnez le GPU. La documentation recommande une RTX 4090 ou une L40 pour SDXL-Turbo, mais un GPU moins cher peut suffire à un modèle plus léger.
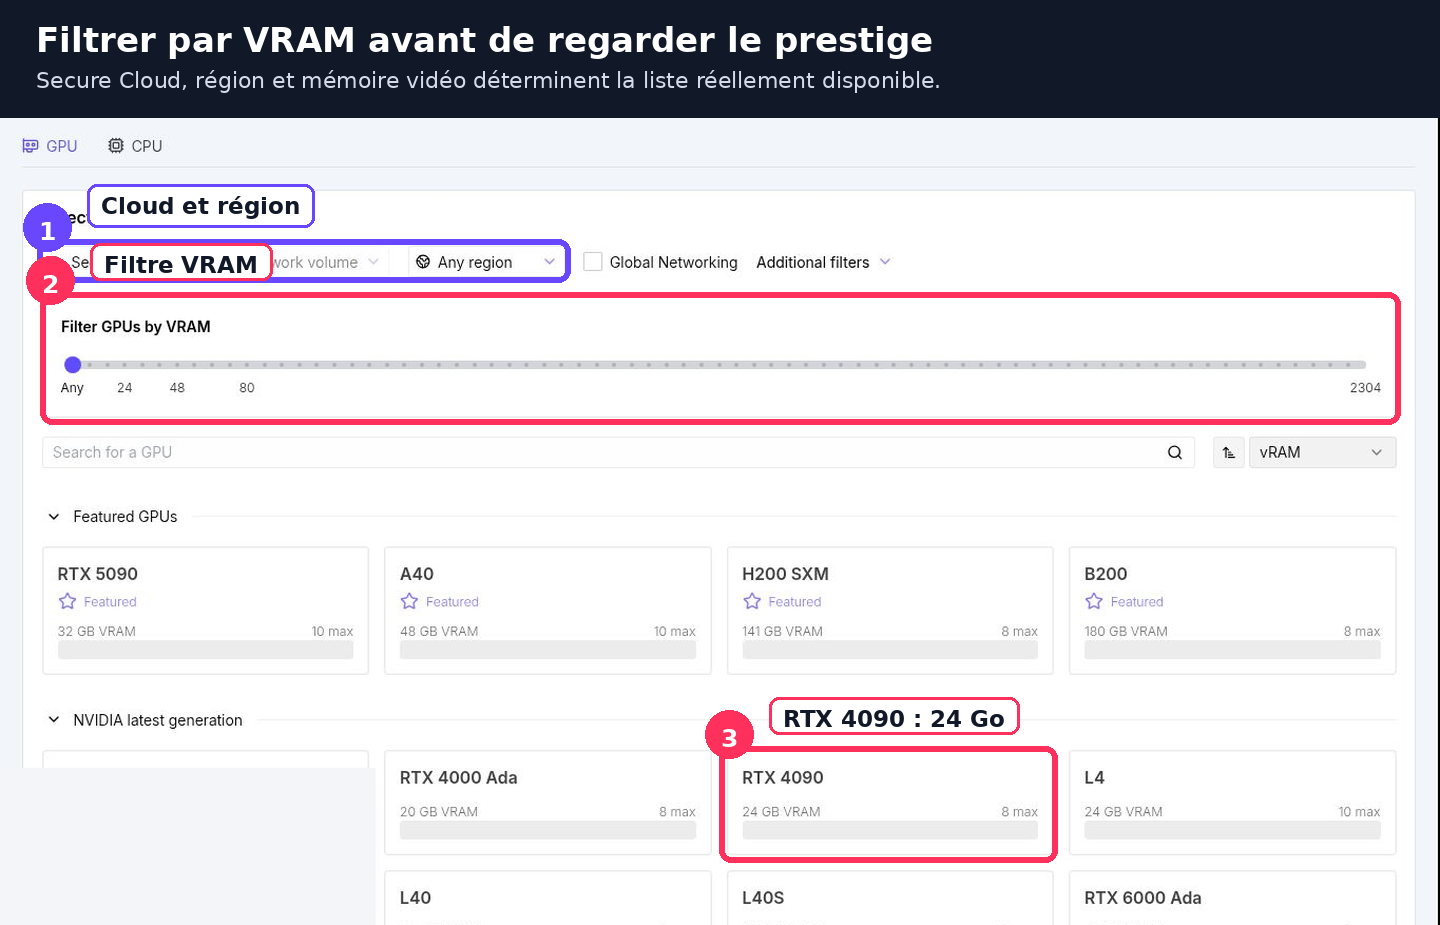
- Configurez le stockage. Pour une découverte, les tailles prévues par le template suffisent. Pour conserver les modèles après la suppression du Pod, attachez maintenant un Network Volume.
- Vérifiez le récapitulatif : prix du GPU, espace disque, type de cloud et centre de données. Donnez un nom reconnaissable au Pod.
- Cliquez sur Deploy On-Demand.
- Patientez. Un Pod simple démarre la plupart du temps en quelques minutes, mais le premier lancement du template ComfyUI peut demander jusqu’à 30 minutes.
Template officiel d’abord. Les templates communautaires peuvent être pratiques, mais Runpod ne les maintient pas et ne fournit pas le même support en cas de panne. Pour apprendre, retirez une variable de l’équation et continuez avec l’image officielle.
Générer sa première image avec ComfyUI
Le Pod affiche Running avant que tous les services soient nécessairement prêts. Ne transformez donc pas le bouton Refresh en instrument de percussion : attendez que le service HTTP de ComfyUI soit disponible.
- Dans la liste des Pods, développez votre instance et cliquez sur Connect.
- Ouvrez Connect to HTTP Service [Port 8188]. L’interface ComfyUI apparaît dans un nouvel onglet.
- Si le bouton indique Not Ready ou si le navigateur affiche Bad Gateway, attendez deux à trois minutes puis actualisez. Au premier démarrage, l’initialisation complète peut être beaucoup plus longue.
- Dans ComfyUI, ouvrez Workflow puis Browse Templates si la galerie ne s’affiche pas automatiquement. Choisissez la catégorie Image et chargez le workflow SDXL-Turbo. Une fois ce test maîtrisé, vous pourrez passer à des workflows plus lourds, comme HiDream-O1-Image dans ComfyUI.
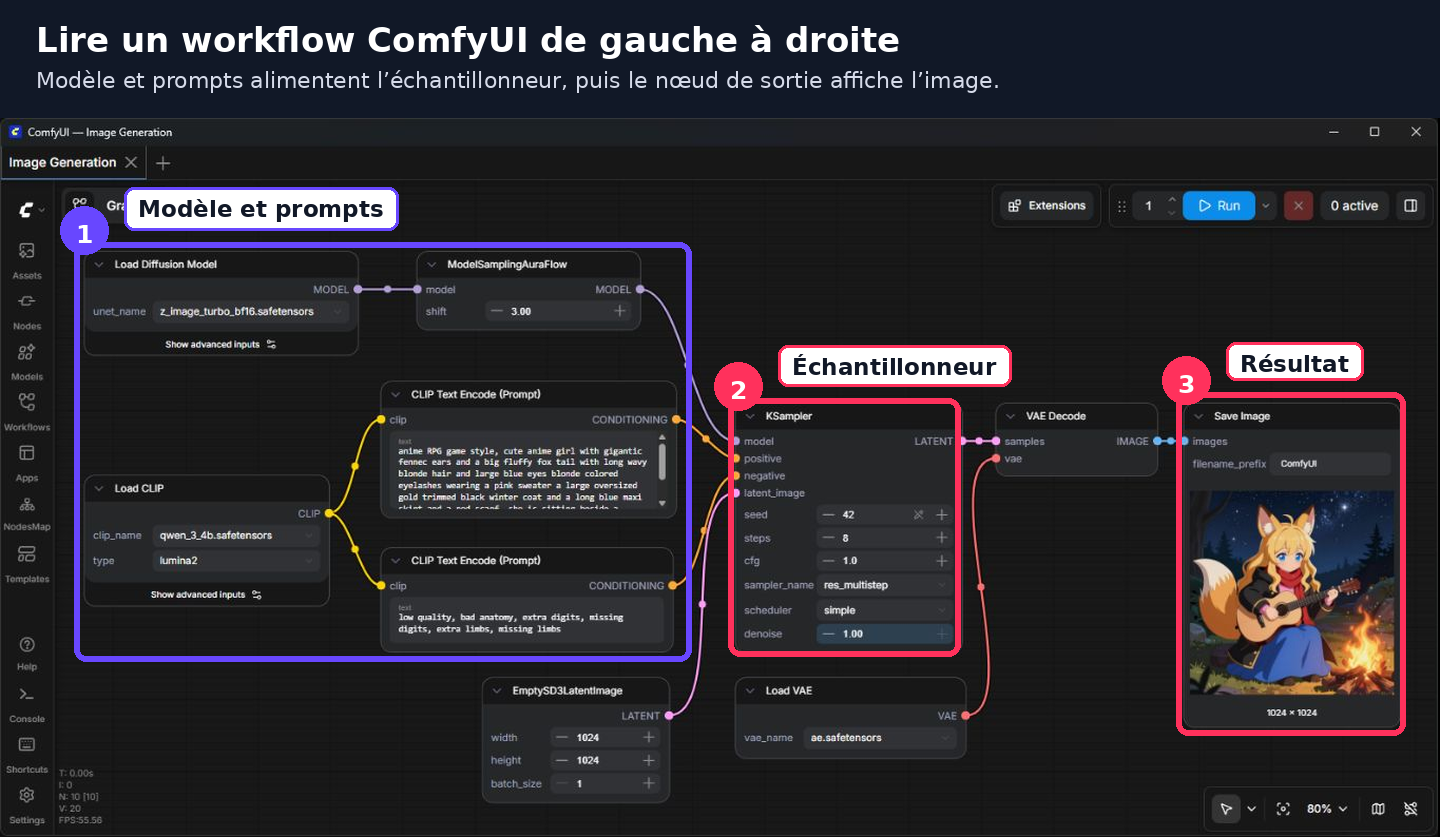
- La fenêtre Missing Models signale que le checkpoint n’est pas présent. Fermez-la, ouvrez Manager puis Model Manager et recherchez SDXL-Turbo 1.0 (fp16). Cliquez sur Install.
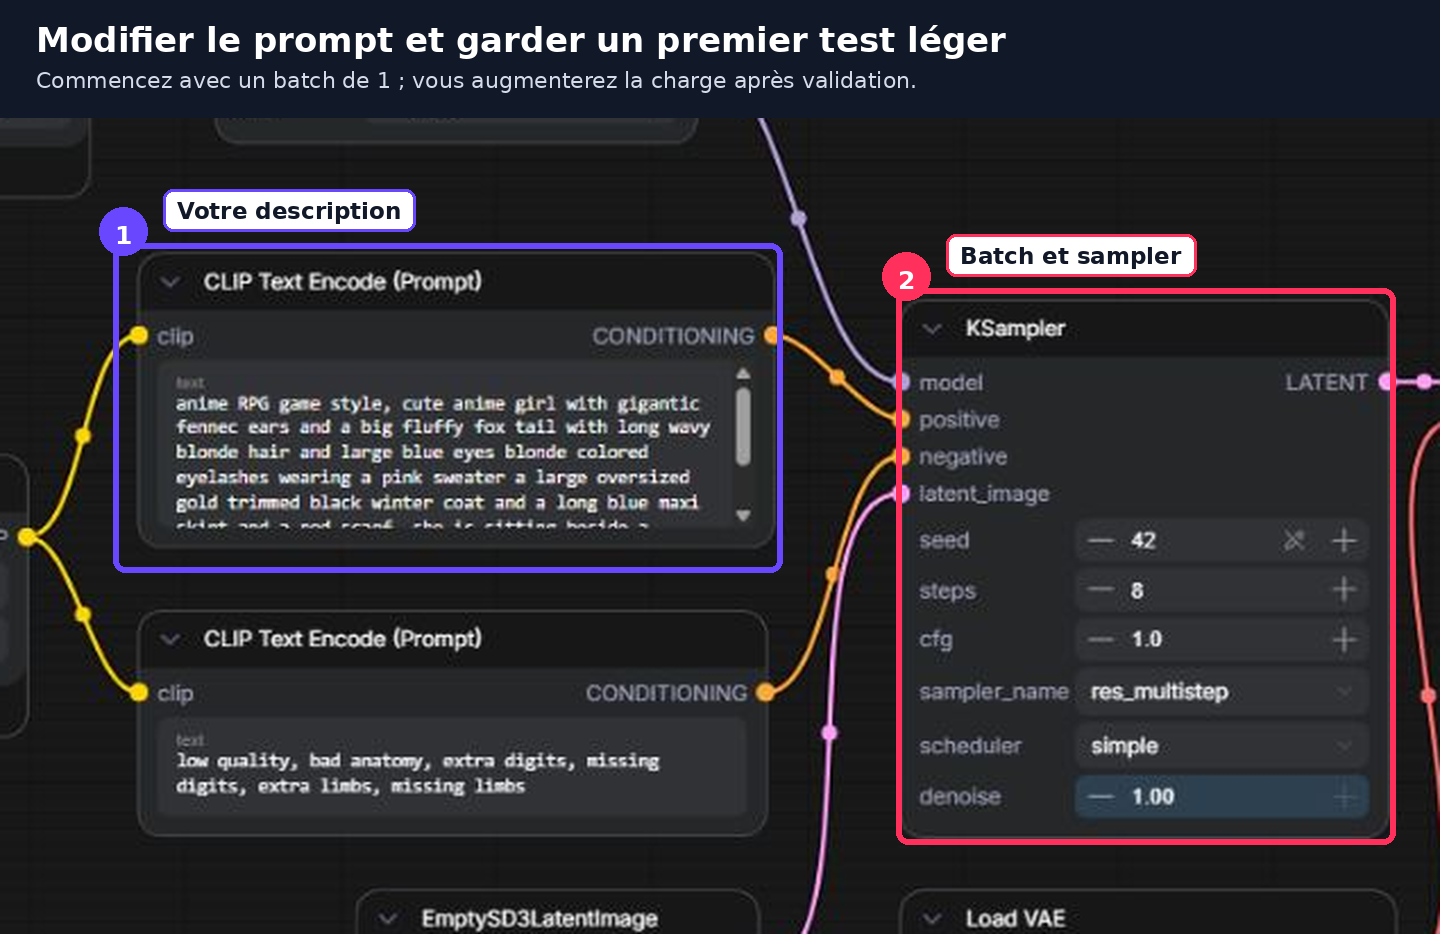
- Actualisez l’interface ou appuyez sur R. Dans le noeud Load Checkpoint, sélectionnez SDXL-TURBO/sd_xl_turbo_1.0_fp16.safetensors.
- Remplacez le texte du noeud CLIP Text Encode (Prompt) par votre description, puis cliquez sur Run ou utilisez Ctrl + Entrée.
- Quand l’image apparaît dans le noeud de sortie, ouvrez-la en pleine résolution et téléchargez-la sur votre ordinateur.
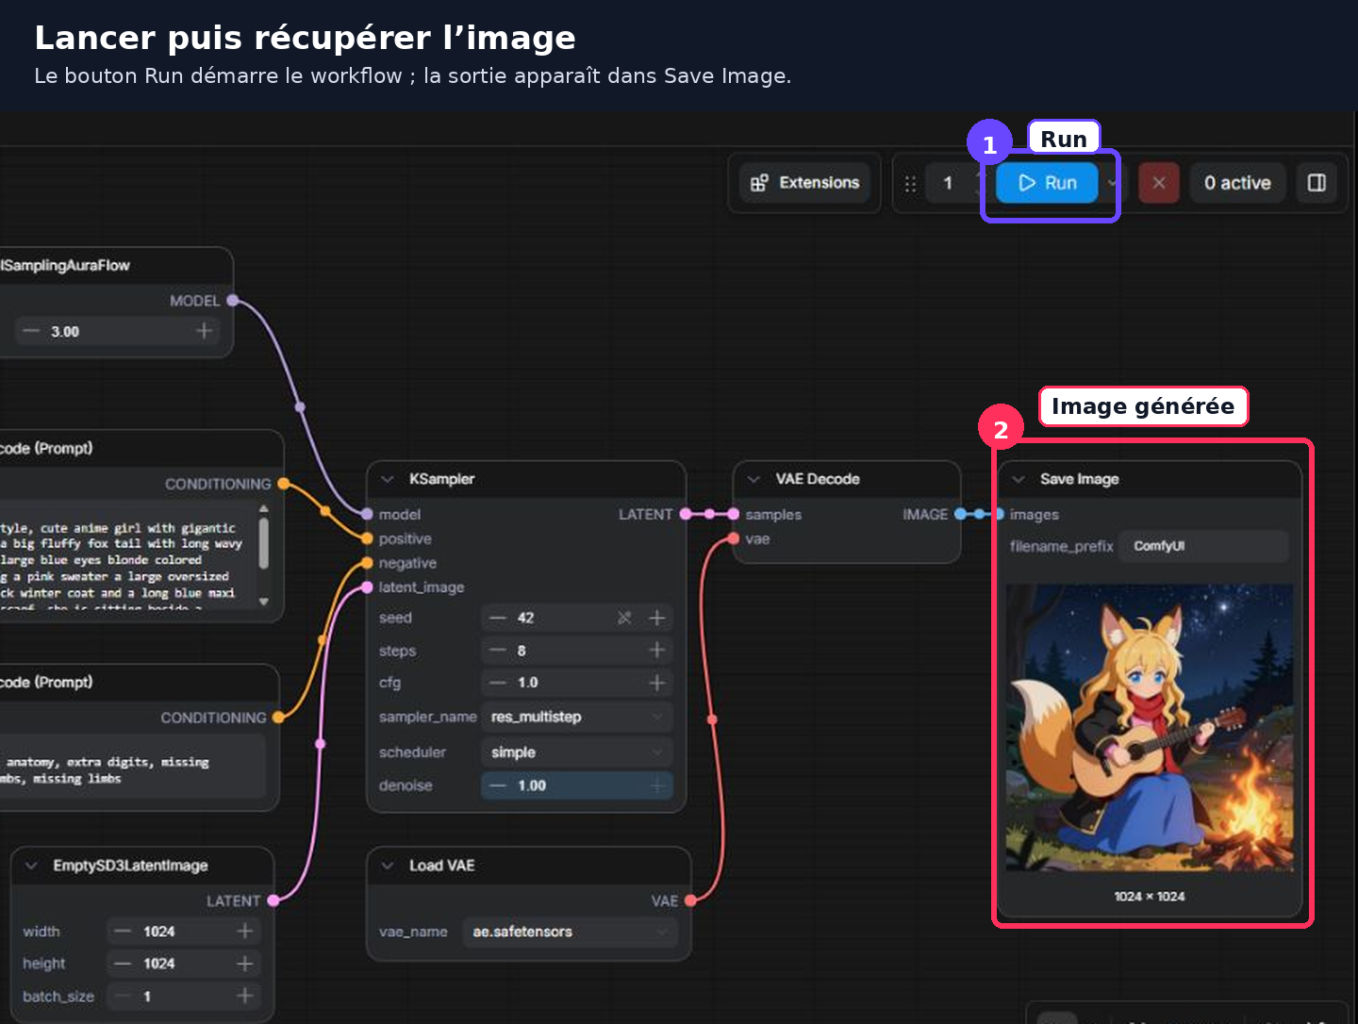
La première génération peut prendre quelques minutes, car le modèle doit être chargé en mémoire. Les suivantes seront nettement plus rapides. Si vous changez de modèle, chargez aussi un workflow conçu pour lui. Remplacer uniquement le checkpoint d’un workflow Flux par SDXL, ou l’inverse, peut produire des erreurs, des performances médiocres ou des résultats incohérents.
Arrêter le Pod sans perdre son travail
La session est terminée, mais le dernier clic compte autant que le premier. Stop libère le GPU et arrête son coût de calcul. Le stockage persistant continue cependant d’être facturé. Terminate supprime le Pod ; tout ce qui n’est pas dans un Network Volume disparaît avec lui.
- Téléchargez les images et workflows que vous voulez conserver.
- Vérifiez que les modèles, LoRA, datasets et sorties importantes se trouvent bien dans le dossier persistant attendu.
- Effectuez une sauvegarde externe des fichiers irremplaçables.
- Cliquez sur Stop pour libérer immédiatement le GPU.
- Utilisez Terminate uniquement lorsque vous acceptez la disparition du Volume Disk. Supprimez aussi le Network Volume lorsqu’il n’a plus aucune utilité.
La règle qui évite la facture fantôme. Considérez chaque Pod comme un taxi avec le compteur allumé. À la fin de la course, vérifiez Billing et la liste des ressources au lieu de fermer simplement l’onglet du navigateur.
Que faire d’autre avec Runpod ?
Faire tourner un LLM
Le template officiel PyTorch ouvre JupyterLab et permet d’utiliser Transformers directement. Le tutoriel actuel de Runpod s’appuie par exemple sur SmolLM3 dans un environnement doté de 24 Go de VRAM. Ollama peut aussi être installé sur un Pod pour exposer une API et servir des modèles ouverts, mais le choix du modèle doit toujours commencer par sa taille et son format de quantification.
Entraîner un LoRA ou affiner un modèle
Le fine-tuning justifie davantage les A100, H100 ou configurations multi-GPU, surtout lorsque le batch, la précision et la vitesse d’entraînement comptent. Le stockage devient alors critique : les checkpoints intermédiaires et le dataset doivent survivre à une interruption et être sauvegardés ailleurs.
Passer du prototype à une API
Une fois le workflow validé sur un Pod, Serverless permet de l’encapsuler dans un worker derrière un Endpoint. Les workers flexibles redescendent à zéro lorsqu’ils sont inutilisés, et les workers actifs se maintiennent chauds pour supprimer le cold start. C’est une décision de production, pas la prochaine case obligatoire d’un parcours débutant.
Appeler un modèle déjà prêt
Si votre objectif consiste seulement à envoyer un prompt à un modèle d’image, de vidéo, d’audio ou de texte, les Public Endpoints évitent de gérer un Pod. Cette simplicité se paie autrement, mais elle peut être préférable à la location d’une machine complète pour quelques appels isolés. C’est aussi une piste pour tester des usages comme Stable Diffusion en temps réel dans la XR sans maintenir une machine active 24 h/24.
Les problèmes les plus fréquents
Le Pod se maintient sur Initializing
Vérifiez d’abord les logs et la télémétrie. Un template ComfyUI peut demander jusqu’à 30 minutes lors de sa première initialisation. Si rien ne progresse, changez de GPU ou de centre de données et vérifiez que le compte possède assez de crédits.
ComfyUI affiche Not Ready, 502 ou Bad Gateway
Le statut Running n’assure pas que le service du port 8188 a terminé son démarrage. Attendez quelques minutes, actualisez et consultez les logs. Sur un template personnalisé, contrôlez également que l’application écoute bien sur 0.0.0.0 et que le port HTTP correct est exposé.
CUDA out of memory
Réduisez la résolution, le nombre d’images générées en parallèle ou la taille du batch. Pour un LLM, utilisez une quantification plus agressive ou un modèle plus petit. Louer davantage de VRAM est la solution la plus directe, mais pas toujours la plus économique.
Le disque est plein
La commande df -h permet d’identifier la partition saturée. Supprimez les checkpoints en double, les caches et les sorties inutiles. La taille d’un Network Volume peut être augmentée, mais pas réduite : ne corrigez pas un manque de ménage par une location permanente de centaines de gigaoctets.
Le GPU n’est plus disponible au redémarrage
Un Pod arrêté libère son GPU. Lors du redémarrage, la capacité peut avoir changé. Un Network Volume facilite alors le redéploiement sur une autre machine compatible sans retélécharger tout le projet. Les ports et l’adresse publique peuvent également changer après un redémarrage, notamment sur Community Cloud.
La facture continue après Stop
Cherchez les autres Pods, Endpoints, workers actifs et volumes. Stop coupe le GPU d’un Pod, pas tous les produits du compte. Le Volume Disk arrêté et le Network Volume se maintiennent comme payants. Billing doit devenir votre dernier écran de chaque session.
Une interface ou une API est exposée publiquement
Les services HTTP et les ports TCP peuvent être accessibles depuis Internet. Ajoutez une authentification, utilisez HTTPS quand il est proposé, protégez les secrets et ne stockez jamais une clé sensible en clair dans un template partagé. Un identifiant de Pod compliqué n’est pas une stratégie de sécurité.
Runpod est-il fait pour vous ?

Runpod convient très bien aux créateurs qui veulent utiliser ComfyUI sans acheter une nouvelle carte graphique, aux développeurs qui testent plusieurs architectures, aux chercheurs qui ont besoin d’une poussée de calcul ponctuelle et aux équipes qui prototypent avant de passer sur une API.
Le service convient moins à quelqu’un qui cherche une sauvegarde permanente, une facture mensuelle totalement fixe ou une expérience aussi simple qu’une application grand public. Il faut comprendre quelques notions de VRAM, de conteneur et de stockage. Rien d’insurmontable, mais suffisamment pour qu’un bouton mal interprété coûte plus cher qu’un abonnement oublié. Si vous préférez une solution clé en main, Adobe Firefly évite justement toute cette couche d’infrastructure.
La vraie force de Runpod n’est donc pas seulement de rendre une H100 accessible en quelques clics. C’est de permettre d’acheter exactement quelques heures de puissance au lieu d’une carte entière. À condition de garder une main sur le workflow et l’autre sur le compteur.
Comment la fin du minage crypto a alimenté l’infrastructure IA ?
Le 15 septembre 2022, la blockchain Ethereum abandonne la preuve de travail. Cet événement marquant s’intitule « The Merge ». La transition vers la preuve d’enjeu rend le minage par carte graphique obsolète. Du jour au lendemain, des millions de GPU se retrouvent totalement inutilisés.
Les exploitants de fermes de minage cherchent rapidement une issue rentable. Ils refusent de brader leurs équipements sur le marché de l’occasion. Ces acteurs reconvertissent leurs machines vers le calcul dédié à l’intelligence artificielle.
Cette mutation industrielle explique la naissance du service Community Cloud chez Runpod. Ces ressources distribuées fournissent des processeurs graphiques grand public à prix réduit. Ce passé minier éclaire les écarts de vitesse constatés entre les instances.
Les cartes assemblées pour la crypto dépendent d’interconnexions PCIe parfois bridées. Leurs réseaux locaux sont moins homogènes que ceux des datacenters professionnels. À l’inverse, l’offre Secure Cloud regroupe des serveurs certifiés ISO/IEC 27001.
Ses centres assurent un réseau performant et une alimentation électrique de secours. Comprendre cette origine aide chaque utilisateur à effectuer un choix éclairé. Vous arbitrez ainsi facilement entre GPU recyclé très économique et infrastructure d’entreprise hautement fiable.
Comparaison des tarifs entre Runpod et les géants du cloud
En 2023, la société Koyeb publie une étude comparative sur le coût des infrastructures cloud. Son rapport analyse la tarification d’une instance NVIDIA A100 80 Go. Une heure de calcul revient à 4,10 $ chez AWS. La même prestation s’élève à 1,39 $ sur Runpod. Cette différence s’explique par une architecture plus directe. Runpod ne propose pas de bande passante garantie.
La plateforme exclut également les contrats de niveau de service pour entreprises. Évaluer ces écarts financiers s’avère indispensable pour piloter un projet d’intelligence artificielle. Le tableau ci-dessous récapitule ces données tarifaires. Il aide à choisir entre les hyperscalers et les hébergeurs spécialisés.
| Modèle GPU | Tarif Hyperscalers (AWS / GCP) | Tarif Runpod (On-Demand) | Écart tarifaire |
|---|---|---|---|
| NVIDIA A100 (80 Go) | 4,10 $/h | 1,39 $/h | -66 % |
| NVIDIA H100 PCIe (80 Go) | 5,12 $/h | 2,89 $/h | -43 % |
| NVIDIA L4 (24 Go) | 0,70 $/h | 0,39 $/h | -44 % |
| NVIDIA RTX 4090 (24 Go) | Non disponible | 0,69 $/h | Exclusivité Cloud Spécialisé |
Foire aux questions
Runpod héberge ses infrastructures en Amérique du Nord, en Europe et en Asie. Sélectionner le centre le plus proche diminue la latence réseau lors des transferts de données.
Le Spot Pod propose une réduction tarifaire atteignant 60 % par rapport au tarif standard. En contrepartie, l’instance est interruptible si un utilisateur On-Demand réclame cette ressource.
Runpod permet de charger n’importe quelle image publique depuis Docker Hub ou GitHub. Ce fonctionnement facilite l’exécution d’environnements virtuels entièrement sur mesure sans configuration lourde.
L’entreprise respecte le RGPD lorsque l’utilisateur sélectionne des centres de données situés dans l’Union européenne. Le traitement des données personnelles dépend toutefois de l’emplacement géographique choisi pour le stockage.
La plateforme accepte les cartes bancaires via Stripe à partir de 10 $ de dépôt. Les règlements en cryptomonnaies sont possibles avec des actifs comme le Bitcoin ou le USDC.
- Partager l'article :
