
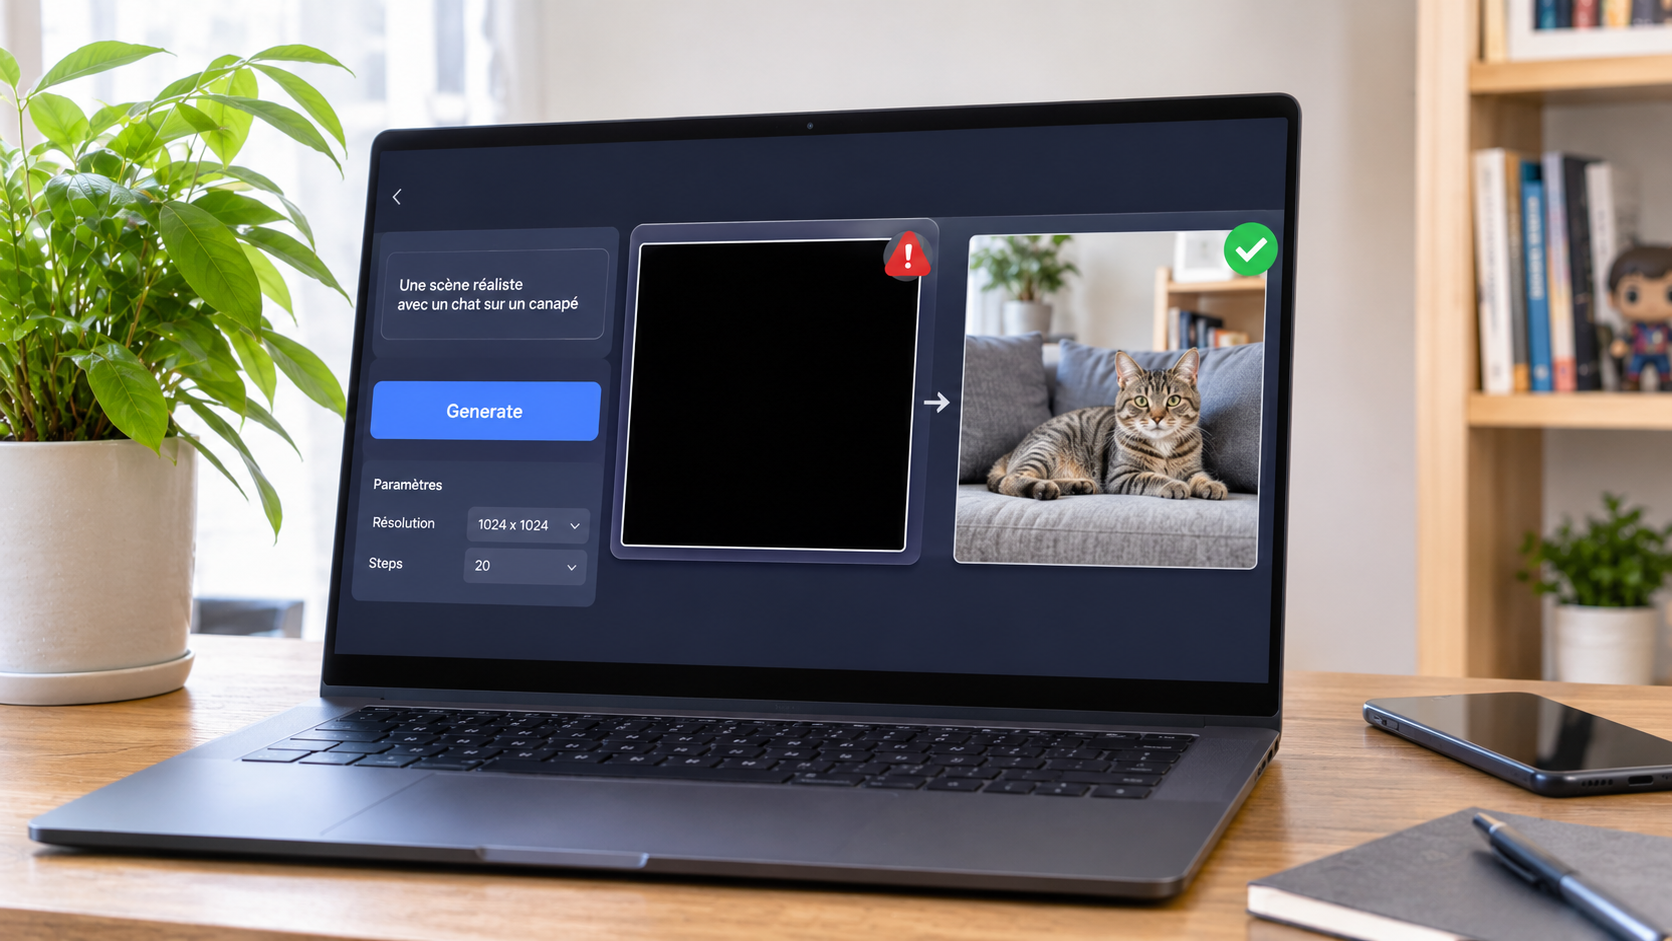

Le développement des modèles génératifs actuels intègre des impératifs de sécurité et de conformité. Pour parer aux risques juridiques, les entreprises commerciales encadrent souvent leurs réponses. Dans ce cadre émerge l’IA dite « non censurée », dont certains garde-fous sont affaiblis ou retirés. Cette dynamique interroge l’équilibre délicat entre liberté d’exploration et encadrement éthique.
Ces versions défiltrées ne reposent pourtant sur aucune avancée technologique secrète ou inédite. Elles dérivent souvent de modèles ouverts aux architectures similaires à celles du grand public. La différence réside dans les données d’affinage et le retrait des comportements de refus. Comprendre ce mouvement exige d’analyser la chaîne technique jusqu’au déploiement local ou décentralisé.

Anatomie du filtrage algorithmique : où se situe la modération native ?
La sécurité d’un modèle d’intelligence artificielle repose sur une défense multicouche. La première strate intervient dès la phase de pré-entraînement. Les ingénieurs emploient des filtres, classifieurs et contrôles de qualité pour écarter les données illicites du corpus. Cette sélection précoce réduit la probabilité de générer des contenus indésirables.
La deuxième strate structure l’alignement comportemental au cours du post-entraînement. Les protocoles de réglage fin et de renforcement humain orientent les probabilités de sortie. Des méthodes comme l’optimisation directe des préférences réduisent le recours à un modèle de récompense explicite. Le modèle apprend ainsi à refuser ou à réorienter les requêtes sensibles.
La troisième strate opère principalement à l’extérieur du modèle, au moyen d’un logiciel intermédiaire. Ce bouclier logiciel intercepte et inspecte le prompt avant son traitement. Des classifieurs spécialisés bloquent les intentions néfastes dès leur première expression. Une ultime vérification filtre la conformité de la réponse avant son affichage à l’écran.
L’IA non censurée face au pré-entraînement et au nettoyage des données
La conception d’un modèle peu filtré remet d’abord en cause l’intensité du nettoyage du corpus initial. Pour entraîner de tels réseaux de fondation, les chercheurs exploitent des archives du web. Les méthodes classiques appliquent des listes de blocage pour écarter certains contenus sensibles. Ce nettoyage préventif écarte d’emblée une partie des pages aux thématiques inappropriées.
Cet assainissement massif peut écarter des documents utiles à certains domaines. Un modèle entraîné sur des données trop expurgées développe ainsi des lacunes de couverture. Ses représentations internes s’avèrent moins complètes face aux vocabulaires pointus. Ce manque de données spécialisées peut handicaper l’analyse de réalités documentaires complexes.
À l’inverse, l’IA peu filtrée conserve une part plus large de la diversité du corpus d’origine. Le traitement des données inclut néanmoins le retrait des doublons, du bruit et de certains contenus à risque. Le système conserve ainsi une modélisation plus étendue du langage, y compris ses conflits. Ce choix ne supprime pas les stéréotypes, mais expose davantage le modèle aux biais présents dans les données.
LLM sans filtre : la déconstruction de l’alignement comportemental
La distinction entre modèle brut et modèle d’instruction éclaire la dynamique sans filtre. Non aligné sur des normes de sécurité explicites, le réseau initial calcule la probabilité du mot suivant. En l’absence de consignes d’alignement, ce moteur statistique n’est pas entraîné à refuser systématiquement les demandes sensibles. Il se contente de poursuivre le texte selon les régularités observées en apprentissage.
Le conditionnement au refus apparaît principalement lors du post-entraînement instructionnel. Pour orienter la retenue, les industriels emploient des milliers de dialogues calibrés. Dès qu’un prompt sensible survient, le modèle associe souvent la requête à une réponse de refus. Cette méthode contraint l’agent conversationnel à adopter des réponses de prudence ou d’évitement.
La communauté open source modifie méthodiquement ce conditionnement comportemental. Les données d’affinage sont filtrées afin de réduire les réponses de refus apprises. Ces barrières cèdent la place à des réponses moins enclines aux refus, sans garantir leur fiabilité. Le réentraînement ou la modification d’architectures ouvertes produit ainsi des agents moins enclins à refuser.
L’ablitération et la neutralisation chirurgicale des vecteurs de refus
Modifier un modèle de neurones par réentraînement complet s’avère fort coûteux en calcul. Une avancée technique permet d’éviter en partie cet écueil grâce au procédé d’ablitération. Des chercheurs ont montré que le mécanisme de refus est souvent encodé dans une direction de l’espace d’activation. Cette posture peut être estimée à partir des réponses du modèle à des invites contrastées.
Chaque couche interne manipule des représentations vectorielles dans le flux résiduel. L’interprétabilité mécaniste compare les réactions face à des invites neutres ou nuisibles. En calculant l’écart moyen entre ces activations, les chercheurs isolent un vecteur de refus. Ce marqueur spatial approxime le comportement d’évitement au sein du modèle.
L’ablitération modifie ensuite directement certaines matrices écrivant dans le flux résiduel. Grâce à une projection orthogonale, la composante associée au refus est réduite dans ces modules. Le transformeur devient dès lors nettement moins enclin à formuler un refus. Ce procédé atténue l’alignement sans garantir l’intégrité totale des capacités du modèle.
Générateurs d’images sans filtre : court-circuiter le pipeline de diffusion
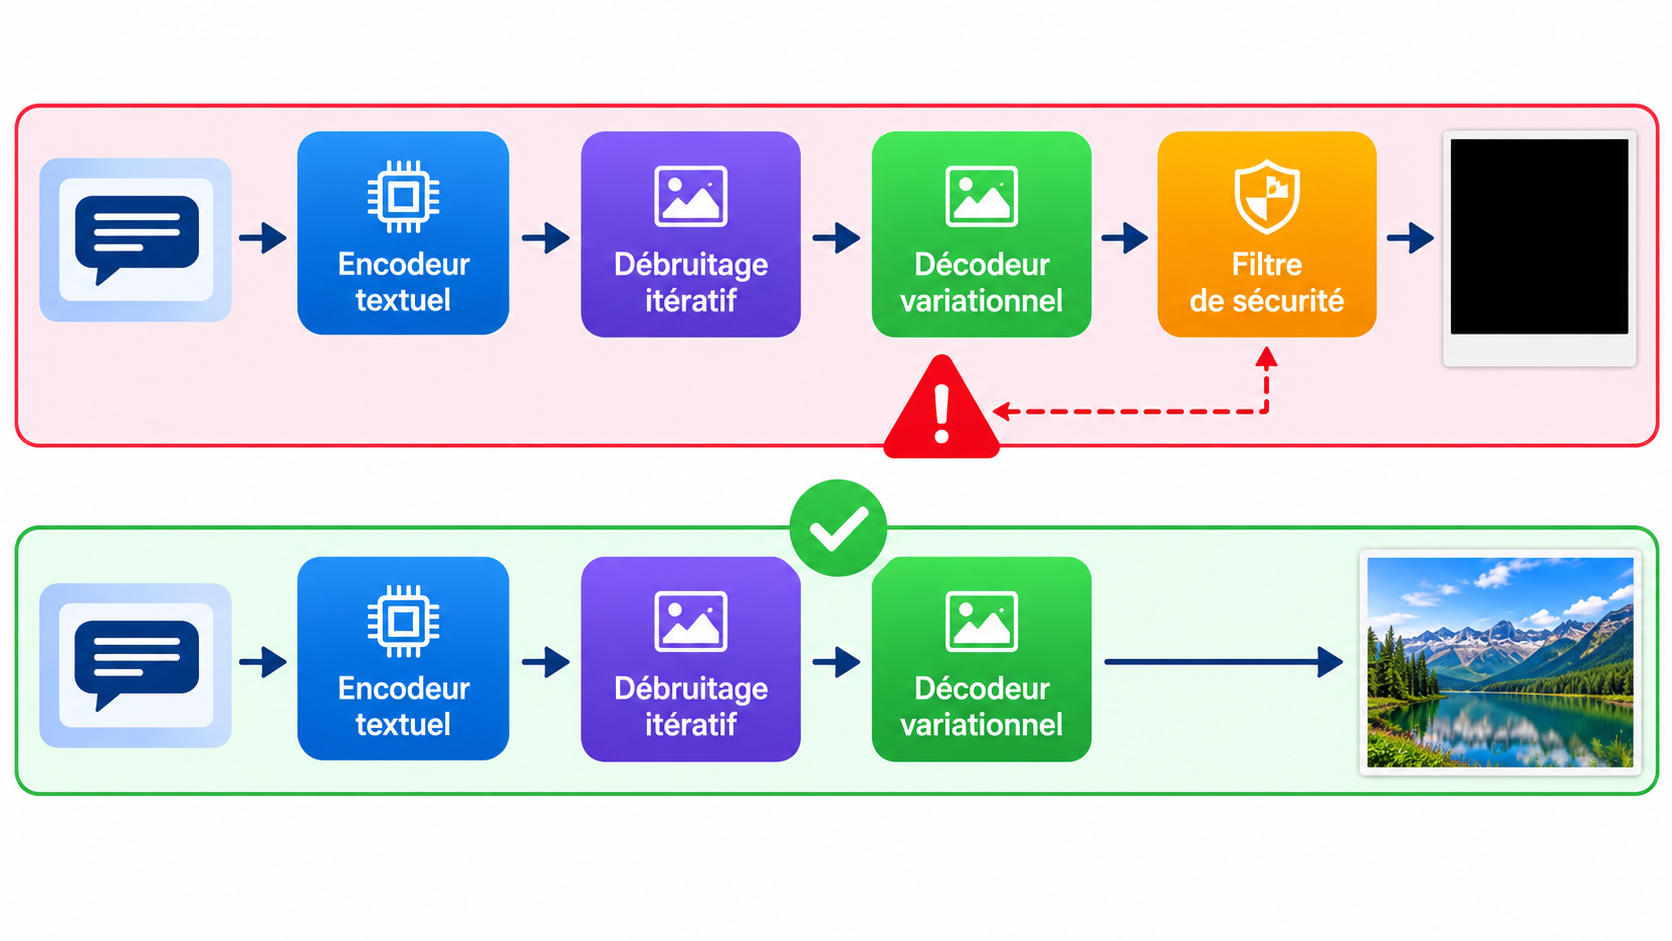
L’essor des modèles d’images peu filtrés repose sur l’exécution locale de poids ouverts. Le traitement conventionnel débute par un encodeur textuel qui convertit la consigne en vecteurs. Un réseau de neurones réalise ensuite le débruitage itératif au cœur de l’espace latent. Un décodeur variationnel restitue finalement la matrice de pixels de l’image achevée.
Les logiciels propriétaires bloquent parfois les termes sensibles ou reformulent certaines consignes. Un filtre externe de sécurité inspecte ensuite l’image après sa conversion par le décodeur. Cet algorithme calcule la similarité cosinus entre le rendu visuel et des thèmes bannis. En cas de score suspect, le script intercepte l’image et lui substitue un carré noir uniforme.
Dans un flux peu filtré, l’architecture d’inférence peut être dispensée de ces contrôles. Le prompt original parvient directement aux encodeurs sans réécriture par un filtre. Le classifieur de sécurité final peut être désactivé ou retiré du code d’exécution. Le réseau restitue ainsi une image davantage conforme au prompt, sans garantir l’absence de biais ou de contenu sensible.
Écosystème open source : checkpoints communautaires, LoRA et fine-tuning
L’absence de filtrage logiciel ne suffit pas à produire des visuels hautement spécialisés. Les modèles de base peuvent comporter des lacunes liées à la collecte ou au filtrage des données. Leurs représentations anatomiques ou graphiques présentent parfois des incohérences structurelles. Une communauté décentralisée s’est alors organisée pour adapter ces architectures ouvertes.
Cet écosystème recourt à l’adaptation de bas rang pour spécialiser ces modèles initiaux. La méthode gèle les poids centraux afin d’insérer des matrices de rang inférieur dédiées. Ces fichiers très légers évitent un réentraînement complet tout en ciblant des notions clés. Les créateurs intègrent ainsi aisément des poses complexes ou des styles très spécialisés.
Parallèlement, la fusion de modèles réunit plusieurs réseaux sans entraînement supplémentaire. Une interpolation linéaire ou sphérique combine les tenseurs de poids de versions compatibles. Cette stratégie produit des fichiers consolidés aux capacités potentiellement diversifiées. La standardisation du format safetensors réduit enfin certains risques liés au chargement de code malveillant.
Déploiement souverain : matériel local et suppression des couches middleware
L’exploitation concrète d’une IA peu contrainte exige une autonomie matérielle importante. Toute requête soumise via une API ou une interface web transite généralement par un tiers. Les fournisseurs de cloud peuvent analyser les adresses IP et journaliser certaines conversations. Ils activent alors des filtres dynamiques difficiles à contourner depuis le poste client.
Cette indépendance passe par l’exécution de l’inférence sur un matériel local, éventuellement une carte graphique. Cette transition s’appuie sur des moteurs de calcul optimisés en C et en C++. Ces logiciels exploitent une quantification poussée pour compresser les poids du réseau. La conversion des virgules flottantes en formats entiers allège la mémoire ou la mémoire vidéo.
Cette optimisation permet d’exécuter des modèles de taille intermédiaire sur un poste standard. Des environnements nodaux et des interfaces dédiées orchestrent localement les calculs. L’ensemble des requêtes peut demeurer largement confiné au sein du poste local. Une configuration sans télémétrie réduit l’exposition des échanges et atténue certains contrôles externes.
Modèles sans filtre : compromis techniques, taxe d’alignement et hallucinations
L’absence de filtrage soulève des arbitrages techniques sur la nature probabiliste de l’IA. Les experts en sécurité évoquent la taxe d’alignement pour décrire cette tension interne. Contraindre un modèle pour garantir sa conformité peut réduire son utilité ou ses performances. Cette modération excessive réduit alors la flexibilité requise pour des tâches complexes.
Dans certains domaines professionnels précis, un modèle peu filtré apporte un avantage pratique. En matière de cybersécurité, le système peut analyser des failles sans rejeter systématiquement l’ordre soumis. L’examen de textes historiques complexes peut bénéficier d’une restitution moins entravée par les refus. Les réponses gagnent enfin en concision en évitant certaines formules de prudence superflues.
En contrepartie, un système affranchi de ses verrous s’avère nettement plus imprévisible. Les garde-fous d’alignement encadrent les réponses en limitant certains contenus ou comportements. Privé de supervision normative, le modèle peut suivre plus directement des demandes ambiguës ou risquées. L’absence de censure lève la réserve, mais n’accroît ni la rigueur ni la fiabilité des réponses.
Enjeux éthiques, cadre réglementaire et transfert de responsabilité juridique
L’essor des technologies peu filtrées redéfinit l’ensemble des responsabilités juridiques. Dans un accès par API commerciale, le fournisseur assume une part des garde-fous techniques. Ses conditions d’usage et ses filtres de modération constituent un premier niveau de prévention. Cette modération centralisée atténue les risques liés aux usages fautifs de l’usager.
À l’inverse, l’usage de poids ouverts accroît la part de responsabilité de l’utilisateur final. Sur sa station de travail personnelle, celui-ci opère comme déployeur du logiciel. Toute utilisation offensive, diffamatoire ou illicite peut engager sa responsabilité. Les poursuites civiles et pénales peuvent alors viser l’opérateur local de la machine.
Les législateurs internationaux peinent à encadrer ce secteur en raison de son double usage. Le cadre européen accorde des exemptions limitées à l’open source, sauf risque systémique. Encadrer ces fichiers de poids se heurte à leur nature de données numériques diffusibles. Je pense que ce décalage contribue à perpétuer un arbitrage délicat entre innovation ouverte et contrôle du risque.
- Partager l'article :
